


وبلاگ
رگرسیون ریج چیست؟ آموزش Ridge Regression، فرمول، کاربردها و مثال

رگرسیون ریج (Ridge Regression) یکی از روشهای مهم رگرسیون خطی منظمشده در یادگیری ماشین است که برای کاهش پیچیدگی مدل و کنترل ضرایب بزرگ استفاده میشود. این روش با اضافه کردن یک جریمه به تابع هزینه رگرسیون خطی، مدل را به سمت ضرایب کوچکتر هدایت میکند.
رگرسیون ریج بهخصوص زمانی مفید است که بین ویژگیهای ورودی همبستگی زیادی وجود داشته باشد، تعداد ویژگیها نسبت به نمونهها زیاد باشد یا رگرسیون خطی معمولی به دلیل حساسیت زیاد به دادههای آموزشی، مدل ناپایداری ایجاد کند.
در این مقاله ابتدا مفهوم رگرسیون خطی را مرور میکنیم، سپس میبینیم Ridge Regression چگونه کار میکند، پارامتر λ چه نقشی دارد، چه تفاوتی با رگرسیون خطی معمولی دارد و در چه شرایطی استفاده از آن منطقی است.
سرفصل محتوا:
رگرسیون ریج چیست؟
رگرسیون ریج نسخهای منظمشده از رگرسیون خطی است که از L2 Regularization استفاده میکند. در رگرسیون خطی معمولی، هدف پیدا کردن ضرایبی است که مجموع خطاهای مربعی پیشبینی را کمینه کنند. در Ridge Regression علاوه بر این خطا، اندازه ضرایب مدل نیز در تابع هزینه وارد میشود.
در نتیجه مدل باید هم خطای پیشبینی کمی داشته باشد و هم از ضرایب بسیار بزرگ اجتناب کند.
تعریف کوتاه: Ridge Regression یک مدل رگرسیون خطی منظمشده است که با استفاده از جریمه L2، ضرایب بزرگ را محدود میکند و میتواند پایداری مدل را در شرایطی مانند چندهمخطی و وجود ویژگیهای زیاد افزایش دهد.
رگرسیون خطی چگونه کار میکند؟
برای درک رگرسیون ریج، ابتدا باید با رگرسیون خطی آشنا باشیم.
در رگرسیون خطی تلاش میکنیم رابطهای میان متغیرهای ورودی و یک متغیر هدف پیدا کنیم. در سادهترین حالت که فقط یک ویژگی داریم، مدل به شکل زیر نوشته میشود:
ŷ = β₀ + β₁x
در این رابطه:
- ŷ مقدار پیشبینیشده توسط مدل است.
- x متغیر ورودی یا Feature است.
- β₀ عرض از مبدأ یا Intercept است.
- β₁ ضریب ویژگی ورودی است.
اگر چند ویژگی داشته باشیم، مدل به شکل رگرسیون خطی چندمتغیره درمیآید:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
هدف رگرسیون خطی پیدا کردن ضرایبی است که پیشبینیهای مدل را تا حد ممکن به مقادیر واقعی نزدیک کنند.
تابع هزینه در رگرسیون خطی
یکی از رایجترین معیارها برای آموزش رگرسیون خطی، مجموع مربعات خطا یا Sum of Squared Errors است.
به صورت ساده، خطای هر نمونه اختلاف میان مقدار واقعی و مقدار پیشبینیشده است:
Error = y − ŷ
با مربع کردن این اختلاف و جمع کردن خطاهای تمام نمونهها، تابع خطای مدل به دست میآید.
مدل رگرسیون خطی تلاش میکند این مقدار را تا حد ممکن کاهش دهد.
مشکل رگرسیون خطی چیست؟
رگرسیون خطی در بسیاری از مسائل عملکرد خوبی دارد، اما در برخی شرایط ضرایب مدل میتوانند بسیار بزرگ شوند. این موضوع بهخصوص زمانی مشکلساز میشود که ویژگیهای ورودی به یکدیگر وابستگی یا همبستگی زیادی داشته باشند.
این وضعیت را چندهمخطی (Multicollinearity) مینامیم.
برای مثال، فرض کنید میخواهیم قیمت خانه را بر اساس متراژ، تعداد اتاقها و تعداد فضاهای داخلی پیشبینی کنیم. اگر چند ویژگی اطلاعات بسیار مشابهی ارائه دهند، مدل خطی ممکن است برای تفکیک اثر آنها ضرایب ناپایدار یا بزرگی ایجاد کند.
رگرسیون ریج با اضافه کردن یک محدودیت به اندازه ضرایب، به کنترل این مشکل کمک میکند.
Ridge Regression چگونه کار میکند؟
ایده اصلی رگرسیون ریج ساده است: علاوه بر کمینه کردن خطای پیشبینی، مدلی را ترجیح میدهیم که ضرایب کوچکتری داشته باشد.
تابع هزینه Ridge Regression را میتوان به صورت زیر نمایش داد:
J(β) = Σ(yᵢ − ŷᵢ)² + λ Σβⱼ²
بخش اول همان مجموع مربعات خطا است و بخش دوم جریمه L2 را نشان میدهد.
در این رابطه:
- λ پارامتر منظمسازی یا Regularization Strength است.
- βⱼ ضرایب مدل هستند.
- مجموع مربعات ضرایب، میزان جریمه مدل را تعیین میکند.
در پیادهسازیهای رایج، جمله مربوط به Intercept معمولاً مشمول جریمه L2 نمیشود.
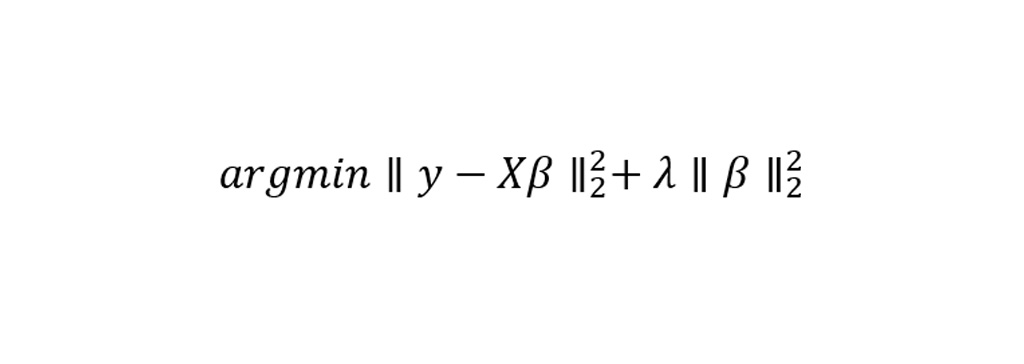
پارامتر λ در رگرسیون ریج چه نقشی دارد؟
λ مشخص میکند که مدل تا چه اندازه باید ضرایب بزرگ را جریمه کند.
- λ = 0: مدل عملاً به رگرسیون خطی معمولی نزدیک میشود.
- λ کوچک: منظمسازی ضعیف است و مدل آزادی بیشتری برای انتخاب ضرایب دارد.
- λ بزرگ: ضرایب بیشتر به سمت صفر کوچک میشوند و مدل سادهتر میشود.
اما λ بسیار بزرگ نیز میتواند مشکلساز شود؛ زیرا ممکن است مدل بیش از حد ساده شده و دچار Underfitting شود.
به همین دلیل مقدار مناسب λ معمولاً با استفاده از داده اعتبارسنجی یا روشهایی مانند Cross-Validation انتخاب میشود.
تفاوت Ridge Regression و Linear Regression
| ویژگی | Linear Regression | Ridge Regression |
|---|---|---|
| نوع مدل | رگرسیون خطی | رگرسیون خطی منظمشده |
| Regularization | ندارد | L2 |
| کنترل ضرایب بزرگ | خیر | بله |
| مقاومت در برابر Multicollinearity | ضعیفتر | بهتر |
| ضرایب دقیقاً صفر | معمولاً خیر | معمولاً خیر |
| پارامتر تنظیمی | ندارد | λ یا α |
Ridge Regression و مشکل Multicollinearity
یکی از مهمترین دلایل استفاده از Ridge Regression، وجود Multicollinearity میان ویژگیهای ورودی است.
وقتی چند Feature اطلاعات مشابهی ارائه میکنند، رگرسیون خطی ممکن است ضرایب بسیار متفاوتی برای آنها ایجاد کند. در نتیجه تغییر کوچکی در دادههای آموزشی میتواند ضرایب مدل را به شکل قابل توجهی تغییر دهد.
Ridge با جریمه کردن مجموع مربعات ضرایب، مدل را به سمت راهحلهای پایدارتر هدایت میکند.
بنابراین هدف Ridge این نیست که ویژگیهای غیرضروری را کاملاً حذف کند؛ بلکه بیشتر تلاش میکند اندازه ضرایب را کنترل و مدل را پایدارتر کند.
Ridge Regression چه تفاوتی با Lasso دارد؟
Ridge و Lasso هر دو روشهای رگرسیون منظمشده هستند، اما نوع جریمه آنها متفاوت است.
| ویژگی | Ridge | Lasso |
|---|---|---|
| نوع Regularization | L2 | L1 |
| نوع جریمه | مجموع مربع ضرایب | مجموع قدرمطلق ضرایب |
| کاهش ضرایب | بله | بله |
| صفر کردن برخی ضرایب | معمولاً خیر | بله |
| Feature Selection | محدود | قویتر |
به همین دلیل اگر هدف اصلی شما کنترل ضرایب و افزایش پایداری مدل باشد، Ridge میتواند انتخاب مناسبی باشد؛ اما اگر علاوه بر منظمسازی به حذف برخی ویژگیها نیز نیاز داشته باشید، Lasso Regression گزینه مهمی است.
چه زمانی از Ridge Regression استفاده کنیم؟
Ridge Regression در شرایط مختلفی میتواند مفید باشد، از جمله:
- وقتی تعداد ویژگیها زیاد است.
- وقتی بین ویژگیهای ورودی همبستگی زیادی وجود دارد.
- وقتی رگرسیون خطی معمولی ضرایب ناپایداری ایجاد میکند.
- وقتی نمیخواهیم ویژگیها بهطور کامل از مدل حذف شوند.
- وقتی هدف کاهش Variance و کنترل پیچیدگی مدل است.
- وقتی تعداد ویژگیها نسبت به تعداد نمونهها زیاد است.
البته استفاده از Ridge به معنی بهتر بودن آن در همه مسائل رگرسیونی نیست. انتخاب مدل باید بر اساس داده، هدف مسئله و ارزیابی روی دادههای دیدهنشده انجام شود.
مثال رگرسیون ریج: پیشبینی حقوق بر اساس تجربه
فرض کنید میخواهیم حقوق یک فرد را بر اساس سابقه کاری او پیشبینی کنیم.
در سادهترین حالت، متغیر ورودی Experience و متغیر هدف Salary است.
رگرسیون خطی تلاش میکند خطی پیدا کند که کمترین خطای ممکن را روی دادههای آموزشی داشته باشد.
حالا فرض کنید به جای یک ویژگی، اطلاعاتی مانند سابقه کار، سن، تعداد پروژهها، سطح مهارت، تعداد ساعات آموزش و سابقه مدیریتی را نیز وارد مدل کنیم. اگر برخی از این ویژگیها اطلاعات مشابهی داشته باشند، رگرسیون خطی ممکن است ضرایب ناپایداری ایجاد کند.
Ridge با اضافه کردن جریمه L2، اندازه این ضرایب را کنترل میکند و در بسیاری از چنین شرایطی میتواند مدل پایدارتر و قابل تعمیمتری ایجاد کند.
یک مثال عملی با Python و Scikit-learn
در Python میتوان Ridge Regression را با استفاده از کتابخانه scikit-learn پیادهسازی کرد.
from sklearn.linear_model import Ridge

model = Ridge(alpha=1.0)

model.fit(X_train, y_train)

y_pred = model.predict(X_test)
در این مثال، پارامتر alpha نقش شدت منظمسازی را دارد. هرچه alpha افزایش پیدا کند، جریمه ضرایب نیز بیشتر میشود.
در یک پروژه واقعی بهتر است مقدار alpha را با استفاده از Cross-Validation انتخاب کنیم، نه اینکه صرفاً یک مقدار دلخواه تعیین کنیم.
from sklearn.linear_model import RidgeCV

model = RidgeCV(
    alphas=[0.01, 0.1, 1, 10, 100],
    cv=5
)

model.fit(X_train, y_train)

print(model.alpha_)
در این روش، مدل مقادیر مختلف alpha را بررسی میکند و با استفاده از Cross-Validation مقدار مناسبتر را انتخاب میکند.
آیا Feature Scaling برای Ridge لازم است؟
از آنجا که Ridge به اندازه ضرایب حساس است، مقیاس ویژگیها اهمیت زیادی دارد. اگر یک Feature در محدوده 0 تا 1 و Feature دیگری در محدوده هزاران باشد، جریمه L2 میتواند اثر متفاوتی روی ضرایب داشته باشد.
به همین دلیل معمولاً بهتر است قبل از آموزش Ridge، ویژگیهای عددی را استانداردسازی کنیم.
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge

model = make_pipeline(
    StandardScaler(),
    Ridge(alpha=1.0)
)

model.fit(X_train, y_train)
استفاده از Pipeline همچنین کمک میکند مراحل پیشپردازش و آموزش مدل به شکل منظمتری انجام شوند.
مزایای Ridge Regression
- کاهش اثر ضرایب بسیار بزرگ
- افزایش پایداری مدل در حضور Multicollinearity
- کاهش احتمال Overfitting در برخی مسائل
- مناسب برای مجموعه دادههایی با ویژگیهای زیاد
- حفظ تمام ویژگیها در مدل به جای حذف مستقیم آنها
- پیادهسازی ساده با ابزارهایی مانند scikit-learn
محدودیتهای Ridge Regression
- Ridge معمولاً ضرایب را دقیقاً صفر نمیکند؛ بنابراین برای Feature Selection ایدهآل نیست.
- انتخاب مقدار نامناسب λ یا alpha میتواند باعث Underfitting یا Overfitting شود.
- به مقیاس ویژگیها حساس است و معمولاً Standardization توصیه میشود.
- اگر رابطه میان متغیرها کاملاً غیرخطی باشد، Ridge خطی بهتنهایی ممکن است مدل مناسبی نباشد.
کاربردهای رگرسیون ریج
Ridge Regression در هر مسئلهای که خروجی عددی باشد و کنترل پیچیدگی مدل اهمیت داشته باشد، میتواند مورد استفاده قرار گیرد.
پیشبینی قیمت مسکن
ویژگیهای مختلفی مانند متراژ، تعداد اتاقها، موقعیت، سن ساختمان و امکانات میتوانند برای پیشبینی قیمت مورد استفاده قرار گیرند. اگر برخی ویژگیها همبستگی زیادی داشته باشند، Ridge میتواند گزینه مناسبی باشد.
پیشبینی مالی
در برخی مسائل مالی، تعداد زیادی متغیر اقتصادی و مالی برای پیشبینی یک متغیر عددی مورد استفاده قرار میگیرد. منظمسازی میتواند به کنترل پیچیدگی مدل کمک کند.
پزشکی و زیستداده
در برخی دادههای زیستی، تعداد ویژگیها میتواند بسیار زیاد باشد. Ridge در چنین شرایطی میتواند برای ساخت مدلهای رگرسیونی منظمشده مورد استفاده قرار گیرد.
پیشبینی تقاضا و فروش
دادههای فروش معمولاً شامل متغیرهای مختلفی مانند قیمت، تخفیف، فصل، تبلیغات و ویژگیهای محصول هستند. Ridge میتواند یکی از مدلهای پایه مناسب برای چنین مسائل رگرسیونی باشد.
Ridge Regression و Bias-Variance Trade-off
یکی از مفاهیم مهم برای درک Regularization، تعادل Bias و Variance است.
مدلهای بسیار پیچیده میتوانند نسبت به تغییرات داده آموزشی حساس باشند و Variance بالایی داشته باشند. Regularization با محدود کردن ضرایب، پیچیدگی مدل را کاهش میدهد و میتواند Variance را کم کند؛ در مقابل، معمولاً مقداری Bias به مدل اضافه میشود.
هدف انتخاب یک مقدار مناسب برای Regularization این است که بین Bias و Variance تعادل مناسبی ایجاد شود تا مدل روی دادههای جدید عملکرد قابل قبولی داشته باشد.
Ridge Regression در یادگیری ماشین چه جایگاهی دارد؟
Ridge Regression یکی از مدلهای کلاسیک و مهم در یادگیری ماشین نظارتشده است. این روش در عین سادگی، یک مفهوم بنیادی در یادگیری ماشین را نشان میدهد: مدل نباید صرفاً روی دادههای آموزشی بهترین عملکرد را داشته باشد؛ بلکه باید بتواند روی دادههای جدید نیز به خوبی تعمیم پیدا کند.
Regularization یکی از ابزارهای مهم برای رسیدن به این هدف است و Ridge نمونهای ساده و قابل فهم از این ایده محسوب میشود.
جمعبندی
رگرسیون ریج (Ridge Regression) نسخه منظمشده رگرسیون خطی است که با استفاده از جریمه L2، ضرایب بزرگ مدل را کنترل میکند. این روش بهخصوص در حضور Multicollinearity، تعداد زیاد ویژگیها یا شرایطی که رگرسیون خطی ضرایب ناپایداری ایجاد میکند، کاربرد دارد.
مهمترین پارامتر Ridge، مقدار λ یا alpha است که شدت Regularization را تعیین میکند. مقدار مناسب آن معمولاً با Cross-Validation انتخاب میشود. همچنین به دلیل حساسیت جریمه L2 به مقیاس ویژگیها، Standardization در بسیاری از پروژهها اهمیت دارد.
اگر Ridge را در کنار Linear Regression، Lasso Regression و Elastic Net یاد بگیرید، تصویر کاملتری از Regularization و نقش آن در ساخت مدلهای رگرسیونی به دست خواهید آورد.
رگرسیون را از تئوری به مهارت عملی تبدیل کنید
اگر میخواهید مدلهای یادگیری ماشین را با Python و پروژههای واقعی یاد بگیرید، مسیر یادگیری مناسب میتواند شما را از مبانی رگرسیون تا ساخت مدلهای عملی پیش ببرد.
سؤالات متداول درباره Ridge Regression
رگرسیون ریج چیست؟
Ridge Regression یک روش رگرسیون خطی منظمشده است که با اضافه کردن جریمه L2 به تابع هزینه، اندازه ضرایب مدل را کنترل میکند.
تفاوت Ridge Regression و Linear Regression چیست؟
رگرسیون خطی معمولی فقط خطای پیشبینی را کمینه میکند، اما Ridge علاوه بر خطای پیشبینی، ضرایب بزرگ مدل را نیز جریمه میکند.
پارامتر alpha در Ridge چیست؟
در scikit-learn، پارامتر alpha شدت منظمسازی Ridge را تعیین میکند. مقدار بزرگتر alpha به معنای جریمه بیشتر برای ضرایب بزرگ است.
آیا Ridge میتواند Overfitting را کاهش دهد؟
بله. Regularization میتواند با کاهش پیچیدگی مدل و محدود کردن ضرایب، در برخی مسائل احتمال Overfitting را کاهش دهد؛ البته مقدار بیش از حد Regularization میتواند باعث Underfitting شود.
تفاوت Ridge و Lasso چیست؟
Ridge از L2 Regularization استفاده میکند و معمولاً ضرایب را به سمت صفر کوچک میکند، در حالی که Lasso از L1 Regularization استفاده کرده و میتواند برخی ضرایب را دقیقاً صفر کند.
آیا قبل از Ridge باید دادهها را Standardize کنیم؟
در بسیاری از مسائل بله. چون Ridge به اندازه ضرایب جریمه وارد میکند، تفاوت مقیاس ویژگیها میتواند بر نتیجه Regularization اثر بگذارد. به همین دلیل StandardScaler در بسیاری از Workflowهای Ridge استفاده میشود.
آیا Ridge برای تعداد ویژگی بیشتر از تعداد نمونهها مناسب است؟
Ridge میتواند در شرایطی که تعداد ویژگیها نسبت به نمونهها زیاد است، گزینه مناسبی باشد؛ زیرا Regularization به کنترل ضرایب و پایداری مدل کمک میکند.