


وبلاگ
رگرسیون چند جملهای چیست؟ راهنمای Polynomial Regression، کاربردها و نحوه انتخاب درجه

رگرسیون چند جملهای یا Polynomial Regression یکی از روشهای رگرسیون برای مدلسازی رابطه میان یک متغیر وابسته و یک یا چند متغیر مستقل است. زمانی که یک خط مستقیم نتواند الگوی موجود در دادهها را بهخوبی توضیح دهد، میتوان با اضافه کردن توانهایی از ویژگیها، مدل انعطافپذیرتری ساخت.
برای مثال، اگر رابطه میان متغیر ورودی و خروجی به شکل یک خط نباشد و دادهها روندی خمیده داشته باشند، یک مدل خطی ساده ممکن است دچار Underfitting شود. رگرسیون چند جملهای میتواند با استفاده از عباراتی مانند x² و x³ شکل پیچیدهتری از رابطه را یاد بگیرد.
تعریف کوتاه: Polynomial Regression روشی برای مدلسازی رابطه میان متغیرهاست که با افزودن توانهای مختلف ویژگیها، مانند x² و x³، امکان برازش یک منحنی به دادهها را فراهم میکند.
سرفصل محتوا:
رگرسیون چند جملهای چیست؟
در رگرسیون خطی معمولاً تلاش میکنیم رابطه میان متغیر مستقل و متغیر وابسته را با یک خط مستقیم نمایش دهیم:
y = β₀ + β₁x
اما اگر رابطه میان متغیرها خمیده باشد، میتوان ویژگیهای چندجملهای را به مدل اضافه کرد:
y = β₀ + β₁x + β₂x² + β₃x³ + … + βₙxⁿ
در اینجا n درجه چندجملهای یا Degree مدل را مشخص میکند.
نکته مهم این است که با وجود شکل خمیده خروجی، Polynomial Regression از نظر پارامترهای مدل همچنان یک مدل رگرسیون خطی محسوب میشود؛ زیرا ضرایب β بهصورت خطی در معادله قرار دارند. چیزی که تغییر میکند، نمایش ویژگیهاست.
چرا از Polynomial Regression استفاده میکنیم؟
فرض کنید مجموعهای از دادهها داریم که رابطه میان ورودی و خروجی در آنها شبیه یک خط مستقیم نیست.
اگر روی چنین دادههایی یک مدل Linear Regression قرار دهیم، مدل مجبور است یک خط مستقیم میان نقاط رسم کند.
در این شرایط، مدل بخش مهمی از الگوی داده را نادیده میگیرد. این وضعیت نمونهای از Underfitting است؛ یعنی مدل آنقدر ساده است که نمیتواند ساختار اصلی داده را بهدرستی یاد بگیرد.
راهکار میتواند اضافه کردن ویژگیهای چندجملهای باشد. برای مثال، علاوه بر x، ویژگیهای x² و x³ نیز وارد مدل میشوند.
معادله رگرسیون چند جملهای چگونه ساخته میشود؟
فرض کنید تنها یک متغیر مستقل به نام x داشته باشیم. یک مدل Polynomial Regression درجه دو به شکل زیر است:
y = β₀ + β₁x + β₂x²
برای مدل درجه سه داریم:
y = β₀ + β₁x + β₂x² + β₃x³
و به همین ترتیب، در مدل درجه n توانهای مختلف متغیر ورودی تا xⁿ به مدل اضافه میشوند.
بنابراین میتوان Polynomial Regression را بهصورت یک Feature Transformation نیز در نظر گرفت. ابتدا ویژگیهای جدید ساخته میشوند و سپس یک مدل Linear Regression روی این ویژگیهای تبدیلشده آموزش داده میشود.
درجه Polynomial Regression چیست؟
Degree یکی از مهمترین پارامترهای رگرسیون چند جملهای است و میزان انعطافپذیری مدل را مشخص میکند.
| درجه | ویژگیهای ایجادشده | ویژگی کلی مدل |
|---|---|---|
| 1 | x | مشابه رگرسیون خطی |
| 2 | x ، x² | قادر به مدلسازی انحناهای ساده |
| 3 | x ، x² ، x³ | انعطافپذیری بیشتر |
| 10 | x تا x¹⁰ | مدل بسیار انعطافپذیر |
افزایش Degree الزاماً به معنای بهتر شدن مدل نیست. با افزایش بیش از حد درجه، مدل ممکن است بهجای یادگیری الگوی اصلی، نویز موجود در دادههای آموزشی را نیز یاد بگیرد.
مقایسه رگرسیون خطی، درجه دوم و درجه سوم
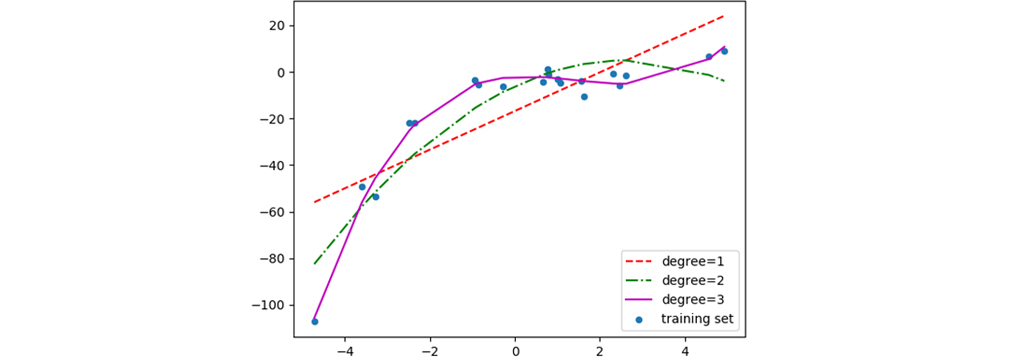
درجه یک همان رگرسیون خطی ساده است و تنها قادر به ایجاد یک خط مستقیم است. با افزایش درجه به دو یا سه، مدل میتواند منحنیهای پیچیدهتری را نمایش دهد.
اما هدف، انتخاب بالاترین Degree ممکن نیست. هدف این است که سادهترین مدلی را پیدا کنیم که بتواند الگوی واقعی داده را بهخوبی یاد بگیرد و روی دادههای جدید نیز عملکرد مناسبی داشته باشد.
افزایش بیش از حد Degree و مشکل Overfitting
اگر درجه مدل را بیش از اندازه افزایش دهیم، منحنی میتواند بسیار انعطافپذیر شود و از تعداد زیادی از نقاط آموزشی عبور کند.
برای مثال، ممکن است یک مدل درجه 20 بتواند دادههای آموزشی را تقریباً کاملاً برازش کند؛ اما این موضوع لزوماً به معنای عملکرد بهتر نیست. چنین مدلی ممکن است روی دادههای جدید خطای زیادی داشته باشد.
این وضعیت Overfitting یا بیشبرازش نام دارد.
بنابراین در Polynomial Regression نیز مانند سایر مدلهای یادگیری ماشین باید میان پیچیدگی مدل و توانایی تعمیم آن تعادل ایجاد کنیم.
Bias و Variance در رگرسیون چند جملهای
انتخاب Degree ارتباط مستقیمی با مفهوم Bias-Variance Tradeoff دارد.
Bias چیست؟
Bias خطایی است که معمولاً از ساده بودن بیش از حد مدل و فرضیات محدودکننده آن ایجاد میشود. مدلی با Bias بالا ممکن است نتواند الگوی واقعی دادهها را ثبت کند و در نتیجه دچار Underfitting شود.
Variance چیست؟
Variance نشان میدهد عملکرد مدل تا چه اندازه به دادههای آموزشی خاص وابسته است. مدلهایی با Variance بالا معمولاً بیش از حد به جزئیات و نویز دادههای آموزش حساس هستند و ممکن است دچار Overfitting شوند.
با افزایش Degree معمولاً انعطافپذیری مدل افزایش پیدا میکند. در نتیجه Bias کاهش مییابد، اما در صورت افزایش بیش از حد پیچیدگی، Variance میتواند افزایش پیدا کند.
چگونه Degree مناسب را انتخاب کنیم؟
یکی از اشتباهات رایج این است که Degree را فقط بر اساس ظاهر نمودار انتخاب کنیم. در یک پروژه واقعی بهتر است عملکرد مدل روی دادههایی که در آموزش استفاده نشدهاند نیز ارزیابی شود.
یک روش استاندارد، استفاده از Validation Set یا Cross-Validation است.
- دادهها را به بخشهای آموزش و ارزیابی تقسیم کنید.
- چند Degree مختلف را امتحان کنید.
- مدل را روی دادههای آموزشی آموزش دهید.
- خطای مدل را روی Validation Set یا با Cross-Validation اندازهگیری کنید.
- درجهای را انتخاب کنید که عملکرد مناسبی روی دادههای دیدهنشده داشته باشد.
- در نهایت عملکرد مدل را روی Test Set ارزیابی کنید.
روشهایی مانند Forward Selection و Backward Selection نیز در برخی مسائل برای انتخاب ویژگی یا ساخت مدل به کار میروند، اما برای انتخاب Degree در یک Workflow مدرن یادگیری ماشین، ارزیابی با Validation و Cross-Validation معمولاً روش مستقیمتر و قابل اتکاتری است.
تابع هزینه در Polynomial Regression
پس از تبدیل ویژگیها، میتوان یک مدل رگرسیون را روی دادههای جدید آموزش داد. یکی از رایجترین معیارها برای اندازهگیری خطای مدل، Mean Squared Error (MSE) است.
در MSE، اختلاف میان مقدار واقعی و مقدار پیشبینیشده محاسبه و سپس به توان دو رسانده میشود:
MSE = (1/n) Σ(yᵢ − ŷᵢ)²
هرچه مقدار MSE کمتر باشد، مدل در مجموعه داده مورد ارزیابی خطای کمتری داشته است. البته انتخاب معیار ارزیابی باید با نوع مسئله و هدف پروژه هماهنگ باشد و تنها بر اساس یک معیار نباید درباره کیفیت مدل تصمیم گرفت.
Polynomial Regression و Regularization
افزایش Degree باعث ایجاد ویژگیهای بیشتری میشود و میتواند مدل را نسبت به نویز حساستر کند. یکی از راهکارهای کنترل این پیچیدگی، استفاده از Regularization است.
روشهایی مانند Ridge Regression میتوانند بزرگی ضرایب مدل را محدود کنند و در برخی مسائل به کاهش Overfitting کمک کنند.
در عمل میتوان Polynomial Features را با روشهای Regularization ترکیب کرد تا مدلی با انعطافپذیری مناسب و کنترل بهتر پیچیدگی ایجاد شود.
تفاوت Linear Regression و Polynomial Regression
| ویژگی | Linear Regression | Polynomial Regression |
|---|---|---|
| شکل رابطه در فضای ورودی | خط مستقیم | میتواند خمیده باشد |
| ویژگیهای ورودی | ویژگیهای اصلی | ویژگیهای اصلی و توانهای آنها |
| انعطافپذیری | کمتر | بیشتر |
| ریسک Underfitting | در روابط پیچیده بیشتر | معمولاً کمتر با افزایش Degree |
| ریسک Overfitting | معمولاً کمتر | با Degree بالا بیشتر |
| ماهیت مدل | Linear in Parameters | Linear in Parameters با ویژگیهای چندجملهای |
بنابراین تفاوت اصلی این دو روش در نحوه نمایش ویژگیها و میزان انعطافپذیری مدل است، نه اینکه یکی «خطی» و دیگری لزوماً «غیرخطی» باشد.
رگرسیون چند جملهای در چند متغیر
Polynomial Regression تنها برای یک متغیر مستقل استفاده نمیشود. اگر چند ویژگی داشته باشیم، میتوان ترکیبها و توانهای مختلف آنها را نیز ایجاد کرد.
برای مثال، اگر دو ویژگی x₁ و x₂ داشته باشیم، در Polynomial Features با درجه دو ممکن است ویژگیهایی مانند موارد زیر ایجاد شوند:
- x₁
- x₂
- x₁²
- x₂²
- x₁x₂
این موضوع باعث میشود مدل بتواند برخی تعاملها میان ویژگیها را نیز یاد بگیرد. البته با افزایش تعداد ویژگیها و Degree، تعداد ویژگیهای تولیدشده میتواند بهسرعت افزایش پیدا کند.
کاربردهای Polynomial Regression
Polynomial Regression زمانی میتواند مفید باشد که بر اساس داده یا دانش حوزه انتظار داشته باشیم رابطه میان متغیرها دارای انحنا باشد.
تحلیل روندهای اقتصادی و تجاری
در برخی دادههای اقتصادی یا تجاری ممکن است رابطه میان یک متغیر ورودی و خروجی خطی نباشد و یک روند خمیده مشاهده شود. Polynomial Regression میتواند یک تقریب ساده برای چنین رابطهای ارائه دهد.
مهندسی و کنترل کیفیت
در فرایندهای صنعتی ممکن است تغییر یک پارامتر تولید باعث تغییر غیرخطی در کیفیت محصول شود. مدل چندجملهای میتواند برای تقریب چنین رابطهای استفاده شود.
پیشبینی و تحلیل قیمت
در برخی مسائل تحلیل قیمت، ممکن است برای توصیف یک روند تاریخی از Polynomial Regression استفاده شود. با این حال، استفاده از این روش برای پیشبینی آینده باید با اعتبارسنجی مناسب انجام شود و نباید صرفاً براساس برازش خوب روی دادههای گذشته تصمیم گرفت.
علوم و مهندسی
در برخی آزمایشها، رابطه میان متغیرهای اندازهگیریشده ممکن است با یک تابع چندجملهای بهخوبی تقریب زده شود. در این شرایط مدل میتواند بهعنوان یک ابزار ساده برای توصیف رابطه میان متغیرها استفاده شود.
مزایای Polynomial Regression
- میتواند روابط خمیده را بهتر از یک مدل خطی ساده نمایش دهد.
- پیادهسازی و آموزش آن نسبتاً ساده است.
- میتوان Degree را برای کنترل میزان پیچیدگی مدل تنظیم کرد.
- با بسیاری از ابزارهای استاندارد Machine Learning قابل استفاده است.
- برای تحلیل رابطه میان متغیرها و ساخت مدلهای ساده پیشبینی مناسب است.
- امکان ترکیب با روشهای Regularization وجود دارد.
محدودیتها و معایب Polynomial Regression
- Overfitting: Degree بالا میتواند باعث یادگیری نویز داده شود.
- حساسیت به Outlier: نقاط پرت میتوانند شکل منحنی را بهشدت تغییر دهند.
- افزایش تعداد ویژگیها: در مسائل چندمتغیره، Polynomial Features میتواند تعداد ویژگیها را بهسرعت افزایش دهد.
- Extrapolation: پیشبینی خارج از محدوده دادههای آموزشی ممکن است بسیار ناپایدار باشد.
- تفسیرپذیری کمتر: با افزایش Degree و ایجاد تعامل میان ویژگیها، تفسیر ضرایب میتواند دشوارتر شود.
تفاوت Underfitting و Overfitting در Polynomial Regression
Underfitting زمانی رخ میدهد که مدل برای ثبت ساختار اصلی داده بیش از حد ساده باشد. در این حالت معمولاً خطای آموزش و خطای Validation هر دو بالا هستند.
در مقابل، در Overfitting مدل روی دادههای آموزش عملکرد بسیار خوبی دارد اما روی دادههای جدید عملکرد آن افت میکند.
| وضعیت | Training Error | Validation/Test Error | مشکل اصلی |
|---|---|---|---|
| Underfitting | بالا | بالا | مدل بیش از حد ساده است |
| مدل مناسب | پایین | پایین | تعادل مناسب پیچیدگی و تعمیم |
| Overfitting | بسیار پایین | بالا | مدل بیش از حد پیچیده است |
آیا تقسیم داده به 70 و 30 همیشه درست است؟
در بسیاری از پروژههای آموزشی از تقسیم 70 درصد داده برای آموزش و 30 درصد برای آزمون استفاده میشود؛ اما این یک قانون ثابت نیست.
بسته به اندازه Dataset، نوع مسئله و روش اعتبارسنجی میتوان از نسبتهای دیگری مانند 80/20 استفاده کرد یا از Cross-Validation کمک گرفت.
نکته مهم این است که دادههای Test باید تا پایان فرایند انتخاب مدل تا حد امکان دستنخورده باقی بمانند تا بتوان ارزیابی منصفانهای از عملکرد نهایی مدل داشت.
پیادهسازی Polynomial Regression با Python
در Python میتوان با استفاده از scikit-learn ابتدا ویژگیهای چندجملهای را تولید کرد و سپس یک مدل رگرسیون روی آنها آموزش داد.
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline

model = make_pipeline(
    PolynomialFeatures(degree=3),
    LinearRegression()
)

model.fit(X_train, y_train)

y_pred = model.predict(X_test)
در این مثال، ابتدا ویژگیهای Polynomial تا درجه سه ساخته میشوند و سپس Linear Regression روی ویژگیهای تولیدشده آموزش داده میشود.
در پروژه واقعی بهتر است این فرایند داخل یک Pipeline قرار گیرد تا مراحل تبدیل ویژگی و مدلسازی بهصورت منظم انجام شوند و خطر Data Leakage کاهش پیدا کند.
چه زمانی Polynomial Regression انتخاب مناسبی نیست؟
رگرسیون چند جملهای همیشه بهترین انتخاب برای یک رابطه غیرخطی نیست. اگر دادهها ساختار بسیار پیچیدهای داشته باشند، مدلهای دیگری مانند Decision Tree، Random Forest، Gradient Boosting یا برخی روشهای دیگر میتوانند مناسبتر باشند.
همچنین اگر هدف صرفاً مشاهده یک روند کلی باشد، روشهایی مانند Splines یا مدلهای انعطافپذیرتر ممکن است رفتار مناسبتری داشته باشند.
بنابراین انتخاب Polynomial Regression باید بر اساس ساختار داده، هدف پروژه، حجم داده و عملکرد مدل روی دادههای جدید انجام شود.
چگونه یک Polynomial Regression مناسب بسازیم؟
- مسئله و متغیر هدف را مشخص کنید.
- رابطه میان ویژگیها و Target را با Visualization بررسی کنید.
- دادهها را پاکسازی و آماده کنید.
- یک مدل ساده Linear Regression بهعنوان Baseline بسازید.
- چند Degree مختلف را آزمایش کنید.
- عملکرد مدلها را با Validation یا Cross-Validation مقایسه کنید.
- در صورت نیاز از Regularization برای کنترل پیچیدگی استفاده کنید.
- مدل نهایی را روی Test Set ارزیابی کنید.
- عملکرد و محدودیتهای مدل را در کنار معیارهای کسبوکار تفسیر کنید.
رگرسیون را از یک فرمول به یک مهارت عملی تبدیل کنید
اگر میخواهید مدلهای یادگیری ماشین را با Python و پروژههای واقعی یاد بگیرید، مسیر یادگیری ساختاریافته میتواند نقطه شروع مناسبی باشد.
سؤالات متداول درباره Polynomial Regression
رگرسیون چند جملهای چیست؟
رگرسیون چند جملهای روشی برای مدلسازی رابطه میان متغیرهای مستقل و یک متغیر وابسته است که با افزودن توانهای مختلف ویژگیها، امکان برازش رابطههای خمیده را فراهم میکند.
تفاوت رگرسیون خطی و چند جملهای چیست؟
رگرسیون خطی ساده معمولاً رابطه را با یک خط مستقیم مدل میکند، در حالی که Polynomial Regression با ایجاد ویژگیهایی مانند x² و x³ میتواند رابطههای خمیده را نیز مدل کند.
آیا Polynomial Regression یک مدل غیرخطی است؟
از نظر شکل رابطه میان ورودی و خروجی میتواند غیرخطی باشد، اما از نظر پارامترهای مدل، Polynomial Regression یک مدل Linear in Parameters محسوب میشود؛ زیرا ضرایب مدل بهصورت خطی وارد معادله میشوند.
Degree در Polynomial Regression چیست؟
Degree بیشترین توان ویژگی در چندجملهای را مشخص میکند. برای مثال، Degree برابر 3 یعنی ویژگیهایی مانند x، x² و x³ در مدل استفاده میشوند.
آیا Degree بالاتر همیشه بهتر است؟
خیر. افزایش بیش از حد Degree میتواند باعث Overfitting شود. Degree مناسب باید با استفاده از Validation یا Cross-Validation و با توجه به عملکرد مدل روی دادههای دیدهنشده انتخاب شود.
چگونه از Overfitting در Polynomial Regression جلوگیری کنیم؟
میتوان Degree را کنترل کرد، از Cross-Validation برای انتخاب مدل استفاده کرد، داده کافی در اختیار داشت و در صورت نیاز از روشهای Regularization مانند Ridge Regression کمک گرفت.
آیا Polynomial Regression برای چند ویژگی هم قابل استفاده است؟
بله. در مسائل چندمتغیره میتوان توانها و تعاملهای میان ویژگیها را نیز ایجاد کرد. البته با افزایش تعداد ویژگیها و Degree، تعداد ویژگیهای تولیدشده میتواند بهسرعت افزایش پیدا کند.
جمعبندی
رگرسیون چند جملهای یا Polynomial Regression روشی ساده و کاربردی برای مدلسازی رابطههایی است که با یک خط مستقیم بهخوبی توضیح داده نمیشوند. ایده اصلی آن، ایجاد ویژگیهای چندجملهای مانند x² و x³ و سپس آموزش یک مدل رگرسیون روی این ویژگیهاست.
Degree نقش مهمی در میزان پیچیدگی مدل دارد. Degree پایین ممکن است باعث Underfitting شود و Degree بسیار بالا میتواند خطر Overfitting را افزایش دهد. به همین دلیل انتخاب درجه مناسب باید با ارزیابی روی دادههای دیدهنشده و روشهایی مانند Cross-Validation انجام شود.
Polynomial Regression زمانی ارزشمند است که رابطهای خمیده اما نسبتاً قابل تقریب میان متغیرها وجود داشته باشد. با این حال، نباید صرفاً به دلیل برازش بهتر روی دادههای آموزشی یک مدل پیچیدهتر را انتخاب کرد؛ هدف اصلی، ساخت مدلی است که بتواند الگوی واقعی را یاد بگیرد و آن را به دادههای جدید تعمیم دهد.
از یادگیری الگوریتمها به ساخت مدل واقعی برسید
اگر میخواهید رگرسیون، ارزیابی مدل و سایر مفاهیم Machine Learning را با Python و پروژههای عملی یاد بگیرید، مسیر یادگیری مناسب خود را شروع کنید.
عالی و کامل
سپاسگزاریم.
خیلی عالی توضیح داده شده .
سپاسگزاریم.