


وبلاگ
الگوریتم یادگیری وزندار محلی (LWL) چیست؟ بررسی Local Weighted Learning و LOESS

الگوریتم یادگیری وزندار محلی (LWL) یا Locally Weighted Learning روشی برای یادگیری از دادههاست که برخلاف بسیاری از مدلهای سراسری، تلاش نمیکند یک رابطه واحد برای کل مجموعه داده پیدا کند. در این روش، برای پیشبینی یک نقطه جدید، دادههای نزدیک به آن اهمیت بیشتری پیدا میکنند و نقاط دورتر تأثیر کمتری دارند.
این ایده در روشهایی مانند Locally Weighted Regression و LOWESS/LOESS کاربرد دارد و بهخصوص زمانی مفید است که رابطه میان متغیرها ساده یا کاملاً خطی نباشد. به همین دلیل، یادگیری وزندار محلی میتواند برای تحلیل الگوهای پیچیده، دادههای پراکنده و برخی مجموعههای سری زمانی مورد استفاده قرار گیرد.
سرفصل محتوا:
الگوریتم یادگیری وزندار محلی (LWL) چیست؟
در یادگیری وزندار محلی، به جای اینکه یک مدل واحد برای تمام دادهها ساخته شود، هنگام پیشبینی یک نقطه مشخص، دادههای اطراف آن نقطه با وزنهای متفاوت در نظر گرفته میشوند.
قاعده اصلی ساده است:
- دادههای نزدیک به نقطه موردنظر، وزن بیشتری دریافت میکنند.
- دادههای دورتر، وزن کمتری دریافت میکنند.
- مدل محلی با استفاده از این وزنها برای نقطه موردنظر برازش داده میشود.
بنابراین LWL به جای تلاش برای پیدا کردن یک تابع عمومی برای کل فضای داده، روی ساختار محلی داده تمرکز میکند.
تعریف کوتاه: یادگیری وزندار محلی روشی است که در آن برای پیشبینی هر نقطه، دادههای نزدیکتر اهمیت بیشتری نسبت به دادههای دورتر دارند و یک مدل محلی برای تخمین مقدار موردنظر ساخته میشود.
ایده اصلی LWL چگونه کار میکند؟
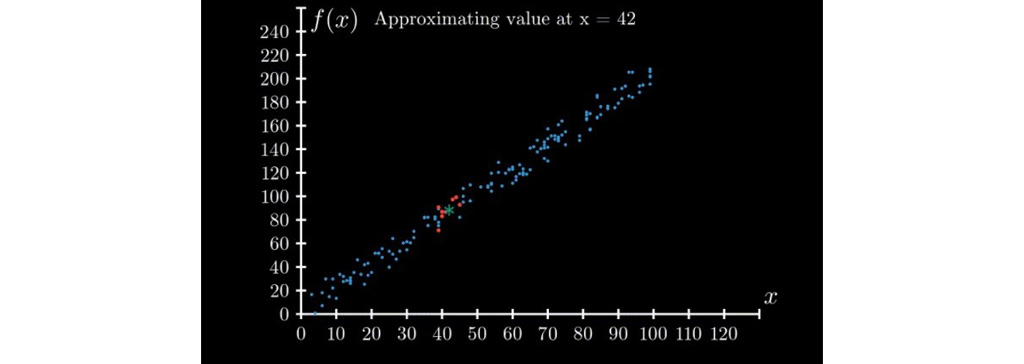
فرض کنید مجموعهای از دادهها در اختیار داریم و میخواهیم مقدار تابع f(x) را در نقطه x = 42 تخمین بزنیم.
در یک روش ساده میتوان دادههایی را که به 42 نزدیکتر هستند انتخاب کرد و با توجه به آنها مقدار خروجی را تخمین زد. اما LWL یک گام جلوتر میرود و لزوماً به تمام نقاط انتخابشده اهمیت یکسان نمیدهد.
برای مثال، اگر چند نقطه در اطراف 42 داشته باشیم، نقطهای که فاصله بسیار کمی از 42 دارد وزن بیشتری دریافت میکند و نقطهای که فاصله بیشتری دارد وزن کمتری خواهد داشت.
در نتیجه، پیشبینی نهایی بیشتر تحت تأثیر ساختار محلی دادهها قرار میگیرد.
رگرسیون مبتنی بر وزن محلی چیست؟
Locally Weighted Regression یکی از کاربردهای مهم ایده یادگیری وزندار محلی در مسائل رگرسیون است.
در رگرسیون خطی معمولی تلاش میکنیم یک رابطه کلی مانند زیر پیدا کنیم:
y = θ₀ + θ₁x
این مدل فرض میکند که رابطه میان متغیر مستقل و وابسته را میتوان با یک خط تقریب زد. اگر ساختار داده غیرخطی باشد، این مدل ممکن است نتواند الگوی موجود را به خوبی نمایش دهد.
در رگرسیون مبتنی بر وزن محلی، به جای اینکه یک رابطه یکسان برای تمام نقاط داده پیدا کنیم، برای نقطهای که میخواهیم مقدار آن را پیشبینی کنیم، یک مدل محلی براساس دادههای اطراف آن برازش میشود.
تفاوت رگرسیون خطی و رگرسیون وزندار محلی
| ویژگی | رگرسیون خطی | رگرسیون وزندار محلی |
|---|---|---|
| نوع مدل | مدل سراسری | مدل محلی |
| تأثیر دادهها | دادهها در برازش کلی مدل مشارکت دارند | دادههای نزدیک وزن بیشتری دارند |
| رابطه دادهها | مناسب برای روابط تقریباً خطی | مناسب برای روابط پیچیدهتر و غیرخطی |
| انعطافپذیری | کمتر | بیشتر |
| هزینه محاسباتی | معمولاً کمتر | معمولاً بیشتر |
چرا از وزندهی محلی استفاده میکنیم؟
یکی از مشکلات مدلهای سراسری این است که ممکن است یک رابطه واحد نتواند رفتار کل مجموعه داده را به خوبی توضیح دهد.
برای مثال، ممکن است دادهها در بخش اول نمودار یک روند افزایشی، در بخش دوم یک روند تقریباً ثابت و در بخش دیگری یک روند کاهشی داشته باشند. در چنین شرایطی، یک خط یا چندجملهای واحد ممکن است نتواند تمام رفتارهای محلی داده را به خوبی نمایش دهد.
LWL این مشکل را با تمرکز بر ساختار اطراف نقطه موردنظر کاهش میدهد.
الگوریتم LWL چگونه وزن دادهها را تعیین میکند؟
در LWL برای هر نقطه داده یک وزن تعیین میشود. این وزن معمولاً تابعی از فاصله آن نقطه تا نقطه موردنظر است.
به صورت مفهومی میتوان رابطه را چنین در نظر گرفت:
w(i) = K(d(x(i), x))
در این رابطه، w(i) وزن نقطه داده، d فاصله میان نقطه داده و نقطه موردنظر و K تابع وزندهی است.
یکی از توابع رایج برای وزندهی، تابع گاوسی است:
w(i) = exp(-‖x(i) – x‖² / 2τ²)
در این رابطه، τ پارامتری است که میزان گستردگی ناحیه محلی را کنترل میکند. مقدار این پارامتر نقش مهمی در میزان هموارسازی مدل دارد.
پارامتر هموارسازی در LWL چه نقشی دارد؟
پارامتر هموارسازی یا Bandwidth مشخص میکند که چه محدودهای از دادهها در برازش محلی اهمیت بیشتری داشته باشند.
اگر این محدوده بسیار کوچک باشد، مدل بیش از حد روی جزئیات محلی تمرکز میکند و ممکن است به نویز داده حساس شود. در مقابل، اگر محدوده بسیار بزرگ باشد، نقاط بیشتری تأثیر قابل توجه پیدا میکنند و مدل به یک رفتار سراسریتر نزدیک میشود.
بنابراین انتخاب مناسب پارامتر هموارسازی برای ایجاد تعادل میان Underfitting و Overfitting اهمیت زیادی دارد.
مثال LWL روی یک مجموعه داده غیرخطی
فرض کنید مجموعهای از نقاط داریم که تقریباً به شکل یک منحنی پراکنده قرار گرفتهاند.
اگر یک رگرسیون خطی روی این دادهها اجرا کنیم، ممکن است خط برازششده فاصله زیادی از بسیاری از نقاط داشته باشد؛ زیرا یک خط نمیتواند انحنای موجود در داده را به خوبی نمایش دهد.
اگر رابطه را به صورت یک چندجملهای سادهتر توسعه دهیم، مثلاً جمله x² را نیز وارد مدل کنیم، ممکن است برازش بهتری به دست آوریم.
با این حال، افزایش بیرویه درجه چندجملهای همیشه راهحل مناسبی نیست. یک مدل بسیار پیچیده ممکن است به جای یادگیری الگوی اصلی، نویز و جزئیات تصادفی دادههای آموزشی را نیز یاد بگیرد.
ارتباط LWL با LOWESS و LOESS چیست؟
LOWESS و LOESS از روشهای شناختهشده رگرسیون محلی هستند که ایده اصلی وزندهی به دادههای نزدیک را به شکل ساختاریافتهتری اجرا میکنند.
در این روشها، در اطراف هر نقطه موردنظر، یک زیرمجموعه محلی از دادهها انتخاب میشود. سپس یک مدل چندجملهای با درجه پایین با استفاده از حداقل مربعات وزندار روی این دادهها برازش میشود.
وزن نقاط نزدیکتر بیشتر و وزن نقاط دورتر کمتر است. در نهایت، مقدار مدل محلی در نقطه موردنظر به عنوان تخمین تابع رگرسیون در آن نقطه استفاده میشود.
LOESS چیست؟
LOESS مخفف Locally Estimated Scatterplot Smoothing است و برای ایجاد یک منحنی هموار از دادههای پراکنده استفاده میشود.
LOESS معمولاً از چندجملهایهای با درجه پایین در نواحی محلی استفاده میکند و به همین دلیل میتواند بدون فرض کردن یک فرم کلی پیچیده، روندهای غیرخطی موجود در داده را نمایش دهد.
LOWESS چیست؟
LOWESS مخفف Locally Weighted Scatterplot Smoothing است و از نظر ایده بسیار نزدیک به LOESS است. در بسیاری از منابع این دو اصطلاح تقریباً به جای یکدیگر استفاده میشوند، هرچند در برخی پیادهسازیها تفاوتهایی در جزئیات مدل محلی وجود دارد.
تاریخچه LOESS و LOWESS
ایدههای مرتبط با هموارسازی محلی سابقهای طولانی در آمار دارند. روشهایی نزدیک به LOESS در دهه 1960 مطرح شدند و بعدها ویلیام کلیولند این رویکرد را در دهه 1970 توسعه داد و آن را با عنوان LOWESS معرفی کرد.
این روشها بعدها برای انعطافپذیرتر کردن رگرسیون و تحلیل دادههای غیرخطی توسعه پیدا کردند و امروزه نیز در تحلیل اکتشافی داده و نمایش روندهای غیرخطی مورد استفاده قرار میگیرند.
رگرسیون محلی چگونه یک پیشبینی ایجاد میکند؟
فرایند را میتوان به صورت ساده در چند مرحله خلاصه کرد:
- نقطهای که باید برای آن پیشبینی انجام شود مشخص میشود.
- فاصله تمام نقاط داده تا نقطه موردنظر محاسبه میشود.
- برای هر نقطه یک وزن متناسب با فاصله آن تعیین میشود.
- یک مدل ساده مانند رگرسیون خطی یا چندجملهای روی دادههای وزندار برازش داده میشود.
- مدل محلی در نقطه موردنظر ارزیابی میشود.
- مقدار بهدستآمده به عنوان پیشبینی یا تخمین استفاده میشود.
به این ترتیب، مدل برای هر نقطه میتواند رفتار متفاوتی داشته باشد و به ساختار محلی داده واکنش نشان دهد.
مقایسه مدل سراسری و یادگیری محلی وزندار
| مدل سراسری | یادگیری محلی وزندار |
|---|---|
| یک مدل برای کل دادهها ساخته میشود. | مدل بر اساس همسایگی نقطه موردنظر شکل میگیرد. |
| فرض مشخصی درباره فرم کلی رابطه دارد. | به فرم کلی رابطه وابستگی کمتری دارد. |
| محاسبات معمولاً سریعتر هستند. | محاسبات میتوانند سنگینتر باشند. |
| برای روابط ساده و پایدار مناسب است. | برای روابط پیچیده و غیرخطی انعطافپذیرتر است. |
| با اضافه شدن دادهها معمولاً مدل دوباره آموزش داده میشود. | میتوان از دادههای جدید در برازشهای محلی استفاده کرد. |
کاربردهای LWL و LOESS
تحلیل دادههای سری زمانی
رگرسیون محلی میتواند برای نمایش روندهای نرم و غیرخطی در دادههای سری زمانی مورد استفاده قرار گیرد؛ بهخصوص زمانی که هدف، مشاهده روند کلی و کاهش اثر نوسانات کوتاهمدت باشد.
تحلیل اکتشافی داده
LOESS یکی از ابزارهای مفید برای مشاهده رابطه میان دو متغیر در نمودارهای پراکندگی است. منحنی محلی میتواند نشان دهد که آیا رابطه موجود تقریباً خطی است یا الگوهای غیرخطی در داده وجود دارد.
تحلیل روند
در بسیاری از دادههای واقعی، روند موجود ممکن است با یک خط مستقیم قابل توصیف نباشد. مدلهای محلی میتوانند روندهای خمیده و تغییرات تدریجی را بهتر نمایش دهند.
تحلیل دادههای علمی
در پژوهشهای علمی و تجربی، زمانی که فرم دقیق رابطه میان متغیرها از قبل مشخص نیست، روشهای هموارسازی محلی میتوانند برای بررسی اولیه ساختار داده مفید باشند.
مزایای الگوریتم یادگیری وزندار محلی
- انعطافپذیری بالا: برای روابط غیرخطی و پیچیده مناسب است.
- عدم نیاز به فرم عمومی پیچیده: لازم نیست از ابتدا یک تابع جهانی دقیق برای کل داده تعریف شود.
- تمرکز بر ساختار محلی: رفتار داده در اطراف هر نقطه اهمیت بیشتری پیدا میکند.
- مناسب برای تحلیل اکتشافی: میتواند برای کشف روندهای پنهان در دادههای پراکنده مفید باشد.
- قابلیت نمایش روندهای غیرخطی: در بسیاری از نمودارهای پراکندگی میتوان از LOESS برای نمایش روند کلی استفاده کرد.
معایب و محدودیتهای LWL و LOESS
- هزینه محاسباتی: برازشهای محلی میتوانند نسبت به یک مدل سراسری محاسبات بیشتری نیاز داشته باشند.
- حساسیت به انتخاب پارامتر هموارسازی: انتخاب نامناسب Bandwidth میتواند به بیشبرازش یا کمبرازش منجر شود.
- نیاز به داده کافی: در نواحی کمتراکم، مدل محلی ممکن است تخمین پایداری نداشته باشد.
- تفسیر دشوارتر: نتیجه یک مدل محلی معمولاً مانند یک معادله ساده قابل بیان نیست.
- حساسیت به دادههای پرت: نقاط پرت میتوانند روی برازش محلی تأثیر بگذارند، بهخصوص اگر در ناحیه موردنظر قرار داشته باشند.
- مناسب نبودن برای همه مسائل: اگر هدف تولید یک مدل صریح و قابل استفاده برای پیشبینیهای گسترده باشد، روشهای پارامتریک یا مدلهای دیگر ممکن است انتخاب مناسبتری باشند.
یادگیری ماشین را با پروژههای واقعی تجربه کنید
اگر میخواهید مفاهیم یادگیری ماشین را فقط به صورت تئوری یاد نگیرید، مسیر یادگیری ساختاریافته میتواند شما را از مبانی داده تا اجرای پروژههای واقعی همراهی کند.
تفاوت LWL با KNN چیست؟
الگوریتم K-Nearest Neighbors (KNN) و یادگیری وزندار محلی هر دو به مفهوم همسایگی وابسته هستند، اما یکسان نیستند.
در KNN معمولاً نزدیکترین نمونهها برای پیشبینی انتخاب میشوند و بسته به نوع مسئله، از رأیگیری یا میانگینگیری استفاده میشود. در LWL، علاوه بر استفاده از اطلاعات محلی، یک مدل محلی وزندار برای تخمین مقدار هدف برازش داده میشود.
| ویژگی | KNN | LWL |
|---|---|---|
| ایده اصلی | استفاده از همسایههای نزدیک | برازش مدل با استفاده از دادههای محلی وزندار |
| وزن فاصله | میتواند استفاده شود | جزء مهم روش است |
| مدل محلی | معمولاً مدل جداگانهای برازش نمیشود | مدل محلی برازش داده میشود |
| کاربرد | Classification و Regression | بیشتر برای Regression و Smoothing |
آیا LWL دچار بیشبرازش میشود؟
بله. انعطافپذیری بالای روشهای محلی میتواند باعث Overfitting شود.
اگر ناحیه محلی بیش از حد کوچک انتخاب شود، مدل ممکن است بیش از اندازه به نقاط نزدیک و حتی نویز حساس شود. در چنین شرایطی مدل روی دادههای موجود عملکرد بسیار خوبی خواهد داشت، اما ممکن است روی دادههای جدید ضعیف عمل کند.
از طرف دیگر، اگر ناحیه مورد استفاده بسیار بزرگ باشد، اثر دادههای دور افزایش پیدا میکند و مدل ممکن است نتواند تغییرات محلی را به خوبی دنبال کند.
بنابراین انتخاب مناسب پارامتر هموارسازی و ارزیابی مدل روی دادههای مناسب اهمیت زیادی دارد.
LWL برای چه نوع دادههایی مناسب است؟
این روش زمانی میتواند انتخاب مناسبی باشد که:
- رابطه میان متغیرها غیرخطی باشد.
- ساختار محلی داده اهمیت داشته باشد.
- هدف اصلی، تحلیل روند یا تخمین یک رابطه نرم باشد.
- فرم ریاضی دقیق رابطه از قبل مشخص نباشد.
- تعداد دادهها برای ایجاد تخمینهای محلی کافی باشد.
در مقابل، برای دادههای بسیار بزرگ یا مسائلی که به یک مدل صریح و بسیار سریع برای پیشبینی نیاز دارند، باید هزینه محاسباتی و گزینههای جایگزین نیز بررسی شوند.
پیادهسازی LOESS در Python
در Python میتوان از کتابخانههایی مانند statsmodels برای اجرای LOESS استفاده کرد. برای مثال، تابع lowess() امکان برازش یک منحنی هموار محلی روی دادههای پراکنده را فراهم میکند.
یک نمونه ساده از ساختار کد به صورت زیر است:
from statsmodels.nonparametric.smoothers_lowess import lowess

result = lowess(y, x, frac=0.3)

x_smooth = result[:, 0]
y_smooth = result[:, 1]
در این مثال، پارامتر frac مشخص میکند چه نسبتی از دادهها در هر برازش محلی مورد استفاده قرار گیرد. انتخاب مقدار مناسب آن به ساختار داده و هدف تحلیل بستگی دارد.
چه زمانی LWL انتخاب مناسبی نیست؟
با وجود انعطافپذیری بالا، LWL همیشه بهترین انتخاب نیست. اگر مجموعه داده بسیار بزرگ باشد، هزینه انجام محاسبات محلی میتواند قابل توجه شود.
همچنین اگر رابطه میان متغیرها از نظر نظری به خوبی شناخته شده باشد و هدف، تخمین پارامترهای مشخص یک مدل باشد، یک مدل پارامتریک مناسب میتواند تفسیرپذیری بیشتری داشته باشد.
بنابراین انتخاب LWL باید بر اساس نوع مسئله، اندازه داده، هدف تحلیل، هزینه محاسبات و میزان تفسیرپذیری موردنیاز انجام شود.
سؤالات متداول درباره LWL
الگوریتم یادگیری وزندار محلی چیست؟
یادگیری وزندار محلی یا LWL روشی است که در آن دادههای نزدیک به نقطه موردنظر وزن بیشتری دریافت میکنند و برای ایجاد یک تخمین یا مدل محلی استفاده میشوند.
رگرسیون وزندار محلی چه تفاوتی با رگرسیون خطی دارد؟
رگرسیون خطی معمولاً یک مدل سراسری برای کل دادهها ایجاد میکند، اما رگرسیون وزندار محلی برای هر نقطه از داده به ساختار محلی و دادههای نزدیک اهمیت بیشتری میدهد.
LOESS و LOWESS چه تفاوتی دارند؟
هر دو روش برای هموارسازی محلی و نمایش روابط غیرخطی استفاده میشوند و در بسیاری از منابع اصطلاحات آنها به جای یکدیگر به کار میرود. تفاوت دقیق آنها میتواند به نحوه انتخاب مدل محلی و پیادهسازی روش مربوط باشد.
آیا LWL یک الگوریتم یادگیری ماشین است؟
بله، LWL را میتوان در دسته روشهای یادگیری مبتنی بر نمونه و روشهای غیرپارامتریک قرار داد. این روش برخلاف مدلهایی که یک تابع عمومی را یکبار برای کل دادهها یاد میگیرند، در زمان پیشبینی از ساختار محلی داده استفاده میکند.
آیا LWL برای دادههای غیرخطی مناسب است؟
بله. یکی از مزیتهای اصلی روشهای یادگیری محلی، انعطافپذیری آنها در نمایش روابط غیرخطی است؛ زیرا لازم نیست یک تابع سراسری ساده مانند خط مستقیم برای کل دادهها فرض شود.
مهمترین محدودیت LWL چیست؟
هزینه محاسباتی، حساسیت به انتخاب پارامتر هموارسازی، نیاز به تراکم مناسب داده و دشوارتر بودن تفسیر مدل از مهمترین محدودیتهای این روش هستند.
جمعبندی
الگوریتم یادگیری وزندار محلی (LWL) روشی است که به جای ایجاد یک مدل واحد برای تمام دادهها، هنگام پیشبینی یک نقطه مشخص، روی دادههای اطراف آن تمرکز میکند. دادههای نزدیک وزن بیشتری میگیرند و در نتیجه ساختار محلی مجموعه داده تأثیر بیشتری بر نتیجه دارد.
یکی از کاربردهای مهم این ایده، Locally Weighted Regression و روشهای LOESS و LOWESS است. این روشها بهخصوص برای بررسی روابط غیرخطی، تحلیل روند و دادههای پراکنده کاربرد دارند.
با این حال، انعطافپذیری بیشتر همیشه به معنای عملکرد بهتر نیست. انتخاب پارامتر هموارسازی، کیفیت داده، تعداد نمونهها و هزینه محاسباتی باید پیش از استفاده از روشهای محلی بررسی شود.
در نهایت، LWL را میتوان روشی مناسب برای زمانی دانست که ساختار محلی داده مهم است و یک مدل سراسری ساده نمیتواند رابطه موجود را به خوبی توصیف کند.
یادگیری ماشین را از الگوریتم به مهارت عملی تبدیل کنید
اگر میخواهید الگوریتمهای یادگیری ماشین را با داده واقعی، Python و پروژههای عملی یاد بگیرید، مسیر آموزشی ساختاریافته راهبرد میتواند نقطه شروع مناسبی باشد.
ممنون از مقاله خوبتون.