


وبلاگ
خوشه بندی سلسله مراتبی چیست؟ راهنمای Hierarchical Clustering

خوشه بندی سلسله مراتبی یا Hierarchical Clustering یکی از روشهای مهم خوشه بندی در یادگیری بدون نظارت است. در این روش، دادهها بر اساس میزان شباهت یا فاصله میان نمونهها بهصورت مرحلهای در یک ساختار سلسله مراتبی قرار میگیرند.
برخلاف روشهایی مانند K-means که معمولاً باید تعداد خوشهها را از ابتدا مشخص کنیم، در خوشه بندی سلسله مراتبی میتوان ساختار گروهبندی دادهها را در سطوح مختلف مشاهده کرد و سپس با استفاده از Dendrogram تعداد خوشههای مناسب را انتخاب کرد.
این ویژگی باعث شده است Hierarchical Clustering برای تحلیل ساختار دادهها، تقسیمبندی مشتریان، دستهبندی اسناد، تحلیل دادههای زیستی و بسیاری از مسائل اکتشافی مورد استفاده قرار گیرد.
سرفصل محتوا:
خوشه بندی چیست؟
خوشه بندی (Clustering) فرایند گروهبندی نمونههای مشابه در یک مجموعه داده است؛ بهگونهای که نمونههای داخل یک گروه نسبت به نمونههای گروههای دیگر شباهت بیشتری به یکدیگر داشته باشند.
برای مثال، فرض کنید اطلاعات مربوط به رفتار خرید مشتریان یک فروشگاه را در اختیار داریم اما از قبل نمیدانیم مشتریان به چه گروههایی تقسیم میشوند. الگوریتم خوشه بندی میتواند مشتریانی با رفتارهای مشابه را در گروههای مختلف قرار دهد.
از آنجا که در خوشه بندی معمولاً برچسب از پیش تعیینشدهای برای دادهها نداریم، این روش در دسته یادگیری بدون ناظر (Unsupervised Learning) قرار میگیرد.
تفاوت خوشه بندی با Classification و Regression چیست؟
یکی از تفاوتهای اصلی بین این روشها، وجود یا نبود متغیر هدف و برچسب در دادههای آموزشی است.
| روش | نوع یادگیری | هدف | مثال |
|---|---|---|---|
| Classification | یادگیری با ناظر | پیشبینی یک کلاس مشخص | تشخیص ایمیل اسپم یا غیر اسپم |
| Regression | یادگیری با ناظر | پیشبینی یک مقدار عددی | پیشبینی قیمت خانه |
| Clustering | یادگیری بدون ناظر | کشف گروههای طبیعی در داده | تقسیمبندی مشتریان |
در Classification و Regression، مدل از دادههای دارای خروجی یا برچسب یاد میگیرد؛ اما در Clustering هدف این است که ساختار یا گروههای موجود در داده بدون داشتن برچسب مشخص کشف شوند.
خوشه بندی سلسله مراتبی چیست؟
Hierarchical Clustering روشی برای خوشهبندی است که رابطه میان نمونهها یا خوشهها را بهصورت یک سلسلهمراتب نمایش میدهد. این سلسلهمراتب معمولاً با یک نمودار درختی به نام Dendrogram نمایش داده میشود.
ایده اصلی ساده است: نمونههایی که به یکدیگر شبیهتر هستند در مراحل اولیه به هم متصل میشوند و با ادامه الگوریتم، خوشههای بزرگتر شکل میگیرند.
در نتیجه به جای اینکه فقط یک تقسیمبندی نهایی داشته باشیم، یک ساختار چندسطحی از نحوه شکلگیری خوشهها در اختیار خواهیم داشت.
انواع خوشه بندی سلسله مراتبی
خوشه بندی سلسله مراتبی بهطور کلی به دو رویکرد اصلی تقسیم میشود:
- Agglomerative Hierarchical Clustering: رویکرد پایین به بالا یا تجمعی
- Divisive Hierarchical Clustering: رویکرد بالا به پایین یا تقسیمی
Agglomerative Hierarchical Clustering چیست؟
در خوشه بندی تجمعی یا Agglomerative، الگوریتم از تعداد زیادی خوشه کوچک شروع میکند و بهتدریج خوشههای مشابه را با یکدیگر ادغام میکند.
اگر مجموعه داده دارای n نمونه باشد، در ابتدای فرایند هر نمونه میتواند یک خوشه مستقل در نظر گرفته شود. سپس در هر مرحله، دو خوشه با توجه به معیار فاصله و روش Linkage انتخابشده با یکدیگر ادغام میشوند.
این فرایند ادامه پیدا میکند تا در نهایت یک خوشه بزرگ باقی بماند یا الگوریتم در سطح موردنظر متوقف شود.
Divisive Hierarchical Clustering چیست؟
در خوشه بندی تقسیمی یا Divisive، فرایند برعکس Agglomerative است. الگوریتم از یک خوشه شامل تمام دادهها شروع میکند و سپس آن را به خوشههای کوچکتر تقسیم میکند.
در ادامه، هر یک از خوشهها میتواند دوباره به زیرخوشههای کوچکتر تقسیم شود تا ساختار سلسله مراتبی کامل شود.
روشهای Divisive نسبت به Agglomerative در کاربردهای عملی رایج کمتری دارند و پیادهسازی آنها نیز میتواند پیچیدهتر باشد.
خوشه بندی سلسله مراتبی چگونه کار میکند؟
برای درک بهتر الگوریتم، روش Agglomerative را در نظر میگیریم. در سادهترین حالت، مراحل الگوریتم به شکل زیر هستند:
- هر نمونه بهعنوان یک خوشه مستقل در نظر گرفته میشود.
- فاصله یا میزان شباهت میان خوشهها محاسبه میشود.
- دو خوشه نزدیکتر بر اساس معیار Linkage انتخاب میشوند.
- دو خوشه با یکدیگر ادغام میشوند.
- فاصله میان خوشههای جدید دوباره محاسبه میشود.
- این فرایند تا ایجاد ساختار سلسله مراتبی کامل ادامه پیدا میکند.
- در نهایت با برش Dendrogram میتوان تعداد خوشههای موردنظر را انتخاب کرد.
بنابراین، الگوریتم فقط به فاصله میان دو نقطه منفرد محدود نیست؛ بلکه وقتی چند نقطه در یک خوشه قرار گرفتند، باید مشخص شود فاصله بین دو خوشه چگونه محاسبه شود. این موضوع با مفهوم Linkage مشخص میشود.
فاصله و معیار Linkage در Hierarchical Clustering
یکی از مهمترین تصمیمها در خوشه بندی سلسله مراتبی، تعیین نحوه اندازهگیری فاصله میان نمونهها و خوشههاست.
برای نمونههای عددی میتوان از معیارهایی مانند Euclidean Distance استفاده کرد؛ اما برای تعیین فاصله میان دو خوشه، روشهای مختلفی وجود دارد.
Single Linkage
در Single Linkage، فاصله دو خوشه بر اساس نزدیکترین دو نمونه از دو خوشه محاسبه میشود.
Complete Linkage
در Complete Linkage، فاصله دو خوشه بر اساس دورترین دو نمونه میان آنها محاسبه میشود.
Average Linkage
در Average Linkage، میانگین فاصله میان نمونههای دو خوشه در نظر گرفته میشود.
Ward Linkage
روش Ward بهجای تمرکز مستقیم بر یک فاصله مشخص میان نقاط، ادغامهایی را انتخاب میکند که افزایش پراکندگی درونخوشهای را تا حد امکان کم نگه دارند. این روش برای بسیاری از دادههای عددی کاربرد دارد و در پیادهسازیهای رایج یادگیری ماشین نیز استفاده میشود.
بنابراین، انتخاب Linkage میتواند روی شکل نهایی خوشهها و نتیجه خوشه بندی تأثیر قابل توجهی داشته باشد.
مثال ساده از خوشه بندی سلسله مراتبی
فرض کنید یک معلم نمره پنج دانشآموز را در اختیار دارد و میخواهد دانشآموزانی را که عملکرد مشابهی دارند در گروههای مختلف قرار دهد.
فرض کنیم نمرهها به شکل زیر باشند:
| دانشآموز | نمره |
|---|---|
| دانشآموز 1 | 12 |
| دانشآموز 2 | 13 |
| دانشآموز 3 | 19 |
| دانشآموز 4 | 20 |
| دانشآموز 5 | 28 |
در ابتدا هر دانشآموز یک خوشه مستقل است. سپس نمونههایی که فاصله کمتری از یکدیگر دارند، مانند دانشآموزان 1 و 2 یا 3 و 4، میتوانند در مراحل اولیه با یکدیگر ادغام شوند.
پس از هر ادغام، فاصله میان خوشههای جدید محاسبه میشود و این روند ادامه پیدا میکند تا یک ساختار سلسله مراتبی شکل بگیرد.
نکته مهم این است که در یک مسئله واقعی، نتیجه به عواملی مانند مقیاس دادهها، معیار فاصله و روش Linkage نیز وابسته است.
ماتریس فاصله در خوشه بندی سلسله مراتبی چیست؟
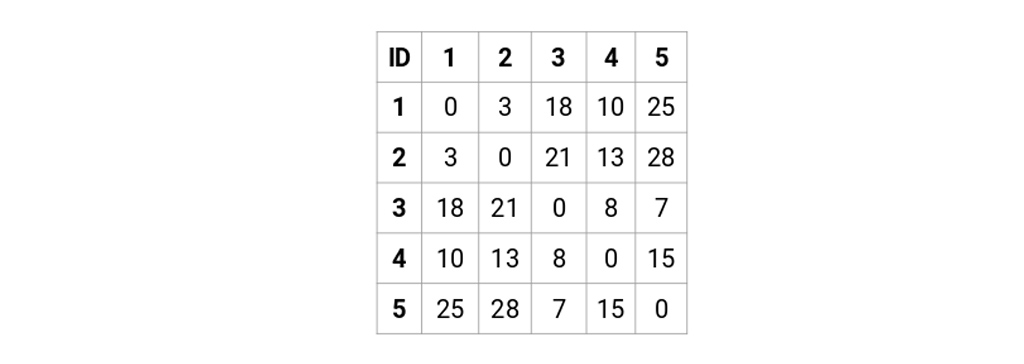
برای اجرای بسیاری از روشهای خوشهبندی، لازم است فاصله میان نمونهها مشخص شود. این فاصلهها میتوانند در قالب یک Distance Matrix یا ماتریس فاصله نمایش داده شوند.
اگر n نمونه داشته باشیم، ماتریس فاصله معمولاً یک ماتریس n×n است که هر خانه آن فاصله میان دو نمونه را نشان میدهد.
فاصله هر نمونه با خودش برابر صفر است و در بسیاری از معیارهای فاصله، ماتریس نسبت به قطر اصلی متقارن خواهد بود.
دندروگرام چیست؟
Dendrogram یک نمودار درختی است که ترتیب ادغام یا تقسیم خوشهها را در خوشه بندی سلسله مراتبی نمایش میدهد.
در روش Agglomerative، هر برگ نمودار معمولاً یک نمونه را نشان میدهد و شاخههایی که در ارتفاعهای مختلف به یکدیگر متصل میشوند، بیانگر ادغام خوشهها هستند.
ارتفاع محل اتصال دو شاخه، بر اساس معیار مورد استفاده، میزان فاصله یا هزینه ادغام آن خوشهها را نشان میدهد.
چگونه تعداد خوشهها را با Dendrogram انتخاب کنیم؟
یکی از مزیتهای مهم Hierarchical Clustering این است که لازم نیست تعداد خوشهها را مانند K-means در ابتدای فرایند تعیین کنیم.
پس از ساخت Dendrogram میتوان یک خط افقی در ارتفاع مشخصی از نمودار رسم کرد. تعداد شاخههای اصلی که این خط قطع میکند، تعداد خوشههای حاصل از آن برش خواهد بود.
برای مثال، اگر خط افقی Dendrogram را در ارتفاعی قرار دهیم که سه شاخه اصلی را قطع کند، میتوانیم سه خوشه داشته باشیم.
نکته مهم این است که انتخاب این ارتفاع نباید صرفاً یک تصمیم بصری و بدون توجه به مسئله باشد. در عمل میتوان از معیارهای ارزیابی خوشهبندی، دانش حوزه و هدف کسبوکار نیز برای انتخاب تعداد خوشهها استفاده کرد.
تفاوت Hierarchical Clustering و K-means چیست؟
هر دو الگوریتم از روشهای شناختهشده خوشهبندی هستند، اما نحوه کار آنها متفاوت است.
| ویژگی | Hierarchical Clustering | K-means |
|---|---|---|
| نوع یادگیری | بدون ناظر | بدون ناظر |
| نیاز به تعیین K در ابتدا | خیر | بله |
| خروجی اصلی | ساختار سلسله مراتبی / Dendrogram | خوشههای نهایی و Centroidها |
| مناسب برای | بررسی ساختار سلسله مراتبی داده | خوشهبندی سریع مجموعههای بزرگتر |
| هزینه محاسباتی | معمولاً بیشتر | معمولاً کمتر |
اگر هدف شما بررسی ساختار روابط میان نمونهها و مشاهده نحوه شکلگیری خوشهها باشد، Hierarchical Clustering میتواند انتخاب مناسبی باشد. در مقابل، K-means برای بسیاری از مسائل با دادههای عددی و تعداد نمونههای زیاد، گزینهای ساده و کارآمد است.
برای آشنایی بیشتر با این الگوریتم، مقاله الگوریتم K-means را نیز مطالعه کنید.
مزایای خوشه بندی سلسله مراتبی
- عدم نیاز به تعیین تعداد خوشهها در ابتدای کار: ساختار کامل خوشهها ایجاد میشود و تعداد خوشهها را میتوان بعداً انتخاب کرد.
- قابلیت مشاهده ساختار داده: Dendrogram تصویری از روابط میان نمونهها و خوشهها ارائه میدهد.
- مناسب برای تحلیل اکتشافی: زمانی که هنوز درباره ساختار داده اطلاعات کافی نداریم، میتواند دید مناسبی ایجاد کند.
- امکان استفاده از معیارهای مختلف فاصله و Linkage: میتوان روش محاسبه فاصله را متناسب با مسئله انتخاب کرد.
- نمایش چندسطحی خوشهها: به جای یک تقسیمبندی ثابت، سطوح مختلف گروهبندی قابل مشاهده هستند.
محدودیتها و معایب خوشه بندی سلسله مراتبی
- هزینه محاسباتی: اجرای Hierarchical Clustering روی مجموعه دادههای بسیار بزرگ میتواند از نظر زمان و حافظه پرهزینه باشد.
- حساسیت به انتخاب معیار فاصله: انتخاب Distance Metric مناسب میتواند تأثیر زیادی بر نتیجه داشته باشد.
- حساسیت به Linkage: روشهای Single، Complete، Average و Ward ممکن است ساختارهای متفاوتی ایجاد کنند.
- حساسیت به مقیاس ویژگیها: اگر ویژگیها مقیاسهای بسیار متفاوتی داشته باشند، فاصلهها ممکن است تحت تأثیر ویژگیهایی با دامنه بزرگتر قرار گیرند.
- ادغامهای برگشتناپذیر در روش Agglomerative: پس از انجام یک ادغام، الگوریتم معمولاً آن تصمیم را در ادامه اصلاح نمیکند.
- تفسیر Dendrogram: انتخاب محل مناسب برای برش نمودار همیشه کاملاً خودکار و قطعی نیست و باید با هدف مسئله و معیارهای ارزیابی همراه شود.
کاربردهای Hierarchical Clustering
تقسیمبندی مشتریان
کسبوکارها میتوانند مشتریان را بر اساس متغیرهایی مانند مبلغ خرید، تعداد سفارش، دفعات مراجعه یا رفتار کاربر به گروههای مختلف تقسیم کنند.
دستهبندی اسناد
در پردازش متن، میتوان اسناد یا مقالات مشابه را بر اساس ویژگیهای استخراجشده از متن در گروههای مختلف قرار داد.
پزشکی و زیستداده
خوشه بندی سلسله مراتبی در تحلیل دادههای زیستی، از جمله گروهبندی نمونههای زیستی یا بررسی شباهت الگوهای بیان ژن، کاربرد دارد. در این کاربردها انتخاب معیار فاصله، پیشپردازش داده و تفسیر زیستی نتایج اهمیت زیادی دارد.
سیستمهای پیشنهاددهنده
با شناسایی گروههایی از کاربران یا محصولات دارای رفتار مشابه، میتوان از اطلاعات بهدستآمده برای طراحی سیستمهای پیشنهاددهی استفاده کرد.
تحلیل رفتار کاربران
دادههای مربوط به تعامل کاربران با یک وبسایت یا محصول دیجیتال میتوانند برای شناسایی گروههای رفتاری مشابه مورد استفاده قرار گیرند.
نکات مهم قبل از اجرای Hierarchical Clustering
نتیجه خوشهبندی فقط به الگوریتم وابسته نیست. آمادهسازی داده و انتخاب تنظیمات مناسب نیز اهمیت زیادی دارد.
- بررسی ویژگیها: ویژگیهایی را انتخاب کنید که واقعاً با مفهوم شباهت در مسئله شما ارتباط دارند.
- مقیاسبندی دادهها: برای ویژگیهایی با مقیاسهای متفاوت، روشهایی مانند Standardization یا Normalization میتوانند ضروری باشند.
- انتخاب Distance Metric: معیار فاصله باید با نوع داده و مسئله سازگار باشد.
- انتخاب Linkage: روشهایی مانند Ward، Complete یا Average میتوانند نتایج متفاوتی ایجاد کنند.
- بررسی Outlierها: نقاط پرت ممکن است ساختار خوشهها را تحت تأثیر قرار دهند.
- ارزیابی نتیجه: خوشهها را فقط بر اساس شکل Dendrogram قضاوت نکنید و از معیارهای کمی و دانش حوزه نیز استفاده کنید.
خوشهبندی را از تئوری به پروژه واقعی تبدیل کنید
اگر میخواهید الگوریتمهای یادگیری ماشین و تحلیل داده را با دادههای واقعی تمرین کنید، مسیر یادگیری ساختاریافته میتواند نقطه شروع مناسبی باشد.
پیادهسازی Hierarchical Clustering با Python
یکی از روشهای رایج برای اجرای خوشه بندی سلسله مراتبی در Python استفاده از کتابخانه scikit-learn است. برای محاسبه و نمایش Dendrogram نیز میتوان از امکانات کتابخانههایی مانند SciPy استفاده کرد.
یک Workflow معمول میتواند شامل این مراحل باشد:
- بارگذاری داده با pandas
- انتخاب ویژگیهای مناسب
- پاکسازی دادهها
- مقیاسبندی ویژگیها در صورت نیاز
- انتخاب معیار فاصله و روش Linkage
- اجرای الگوریتم
- رسم و بررسی Dendrogram
- انتخاب تعداد خوشهها
- ارزیابی و تفسیر خوشهها
این نکته مهم است که اجرای الگوریتم تنها بخش کوچکی از یک پروژه خوشهبندی است. مهمتر از آن، انتخاب ویژگیهای مناسب، تعریف مفهوم «شباهت» و تفسیر خوشههای بهدستآمده است.
آیا Hierarchical Clustering همیشه بهترین انتخاب است؟
خیر. انتخاب الگوریتم باید بر اساس ساختار داده و هدف مسئله انجام شود.
اگر مجموعه داده بسیار بزرگ باشد، هزینه محاسباتی Hierarchical Clustering میتواند یک محدودیت مهم باشد و روشهایی مانند K-means ممکن است گزینه عملیتری باشند.
از طرف دیگر، اگر هدف شما کشف ساختار چندسطحی داده و بررسی روابط میان نمونهها باشد، Dendrogram میتواند اطلاعاتی ارائه دهد که یک تقسیمبندی ساده مانند K-means در اختیار شما قرار نمیدهد.
بنابراین بهتر است Hierarchical Clustering را بهعنوان یکی از ابزارهای موجود در جعبهابزار خوشهبندی در نظر بگیریم، نه راهحل مناسب برای همه مسائل.
سؤالات متداول درباره خوشه بندی سلسله مراتبی
خوشه بندی سلسله مراتبی چیست؟
خوشه بندی سلسله مراتبی یا Hierarchical Clustering یک روش یادگیری بدون ناظر است که نمونههای مشابه را بهصورت مرحلهای در یک ساختار سلسله مراتبی گروهبندی میکند. این ساختار معمولاً با Dendrogram نمایش داده میشود.
آیا در Hierarchical Clustering باید تعداد خوشهها را از ابتدا مشخص کنیم؟
خیر. برخلاف K-means، الگوریتم میتواند ساختار سلسله مراتبی داده را ایجاد کند و سپس با برش Dendrogram در یک سطح مشخص، تعداد خوشههای موردنظر انتخاب شود.
تفاوت Agglomerative و Divisive چیست؟
در Agglomerative، الگوریتم از خوشههای کوچک شروع میکند و آنها را بهتدریج ادغام میکند. در Divisive، الگوریتم از یک خوشه بزرگ شروع میکند و آن را به خوشههای کوچکتر تقسیم میکند.
Dendrogram در خوشه بندی سلسله مراتبی چه کاربردی دارد؟
Dendrogram ترتیب ادغام یا تقسیم خوشهها را نمایش میدهد و کمک میکند ساختار سلسله مراتبی داده را مشاهده کرده و سطح مناسبی برای تعیین تعداد خوشهها انتخاب کنیم.
Linkage در Hierarchical Clustering چیست؟
Linkage روشی است که مشخص میکند فاصله میان دو خوشه چگونه محاسبه شود. Single، Complete، Average و Ward از روشهای رایج Linkage هستند.
آیا Hierarchical Clustering برای دادههای بزرگ مناسب است؟
بسته به پیادهسازی و ساختار داده، هزینه محاسباتی Hierarchical Clustering میتواند با افزایش تعداد نمونهها زیاد شود. بنابراین برای مجموعه دادههای بسیار بزرگ، روشهای دیگر مانند K-means یا الگوریتمهای مقیاسپذیرتر ممکن است انتخاب مناسبتری باشند.
جمعبندی
خوشه بندی سلسله مراتبی یکی از روشهای مهم یادگیری بدون ناظر برای کشف ساختار و گروههای موجود در دادههاست. ویژگی مهم این روش، ایجاد یک سلسلهمراتب از خوشههاست که میتوان آن را با استفاده از Dendrogram مشاهده کرد.
دو رویکرد اصلی این روش Agglomerative و Divisive هستند. در روش Agglomerative، خوشهها از پایین به بالا با یکدیگر ادغام میشوند و در روش Divisive، یک خوشه بزرگ به گروههای کوچکتر تقسیم میشود.
معیار فاصله و روش Linkage نقش مهمی در نتیجه خوشهبندی دارند و انتخاب آنها باید با توجه به نوع داده و هدف مسئله انجام شود. همچنین مقیاس ویژگیها، دادههای پرت و نحوه انتخاب تعداد خوشهها میتوانند بر کیفیت نتیجه تأثیر بگذارند.
در نهایت، Hierarchical Clustering زمانی ارزشمند است که علاوه بر گروهبندی دادهها، بخواهیم ساختار شباهت میان نمونهها و نحوه شکلگیری خوشهها را نیز مشاهده کنیم.
از یادگیری الگوریتمها به حل مسئله با داده برسید
اگر میخواهید Clustering و سایر تکنیکهای یادگیری ماشین را روی دادههای واقعی یاد بگیرید، یک مسیر پروژهمحور میتواند مهارت شما را از تئوری به اجرا منتقل کند.